
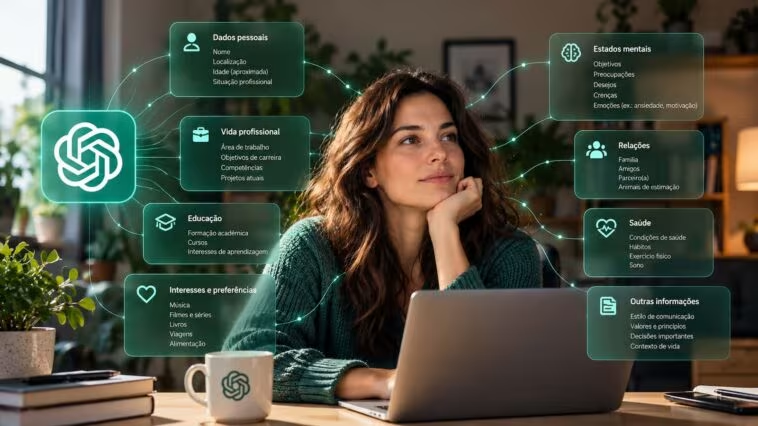
La fonction de mémoire de ChatGPT améliore la personnalisation mais soulève des interrogations sur la confidentialité. Une analyse de plus de 2000 mémoires révèle que le chatbot stocke des informations personnelles et psychologiques sur ses utilisateurs, souvent sans instruction directe.
La mémoire de ChatGPT permet de personnaliser les réponses, mais elle soulève également des questions sur la vie privée. Une étude scientifique a analysé plus de deux mille mémoires et a identifié des informations personnelles et psychologiques stockées par le chatbot d’OpenAI.
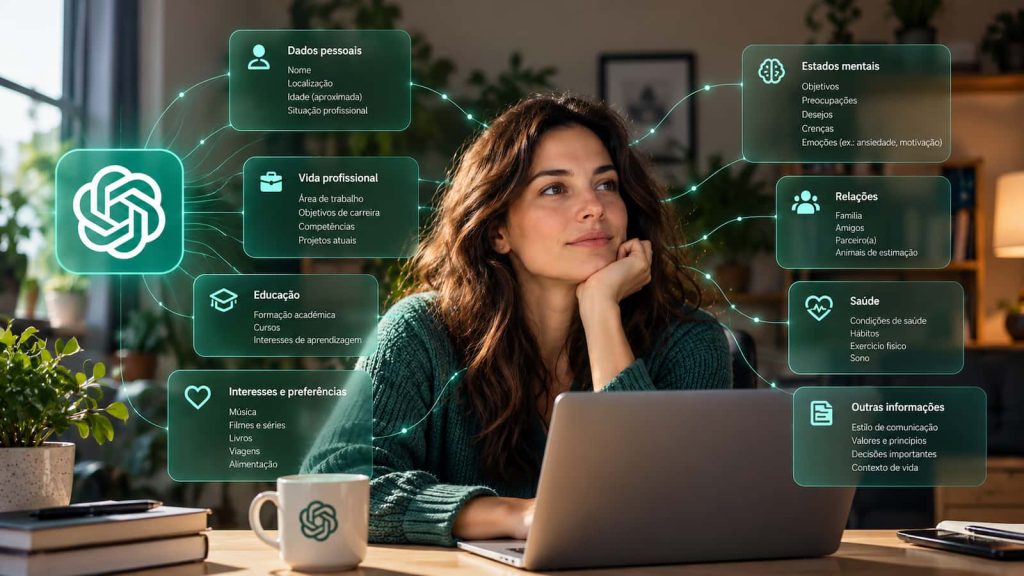
L’intelligence artificielle occupe une place grandissante dans la vie quotidienne, servant à répondre à des questions, aider aux décisions ou discuter de sujets personnels. Les utilisateurs fréquents de ces assistants doivent savoir que leurs conversations peuvent fournir bien plus que les réponses immédiates, permettant au système d’élaborer des profils détaillés à leur sujet.
Publiée lors de l’ACM Web Conference 2026, l’étude « The Algorithmic Self-Portrait: Deconstructing Memory in ChatGPT » a examiné ce phénomène et décrit la création de ce que les chercheurs appellent un « autoportrait algorithmique », construit à partir des informations partagées durant les échanges.
ChatGPT peut enregistrer des informations sans demande explicite
Conduite par des experts de plusieurs institutions, cette recherche a analysé les historiques de conversation de 80 utilisateurs de ChatGPT, obtenus en exerçant les droits d’accès prévus par le RGPD.
Au total, 2050 entrées de mémoire liées à 65 participants ont été identifiées. Pour 96% d’entre elles, les chercheurs n’ont pas trouvé d’instruction claire de l’utilisateur demandant la création ou la mise à jour d’une mémoire, l’initiative venant du système lui-même.
Pour parvenir à ce constat, l’équipe a recherché dans les messages des expressions liées à une demande de mémorisation. Ce résultat ne signifie pas forcément que les utilisateurs ignoraient la fonctionnalité.
Si la mémoire assure une continuité entre les sessions et adapte les réponses aux préférences individuelles, les résultats montrent que la sélection des informations à conserver dépend largement des mécanismes internes du chatbot.
Données personnelles et états mentaux conservés en mémoire
Un des résultats majeurs concerne la nature des informations sauvegardées. D’après les chercheurs, 28% des mémoires examinées contenaient des données personnelles relevant du RGPD, et 7% incluaient des informations classées dans les catégories spéciales de données sensibles par la loi européenne.
De plus, 52% des entrées de mémoire renfermaient des détails relatifs à des états mentaux, comme des désirs, des intentions, des émotions ou des croyances. Parmi ces mémoires, les désirs constituaient la catégorie la plus fréquente, apparaissant dans 73% des cas.
Cette classification a été réalisée à l’aide d’un modèle d’IA puis validée sur un échantillon par des chercheurs humains. Elle ne constitue pas une évaluation psychologique clinique des participants.
Les conclusions suggèrent que la personnalisation offerte par les chatbots peut dépasser le simple souvenir de préférences ou de faits, intégrant aussi des aspects liés aux objectifs et intentions exprimés par les utilisateurs.
Le problème des conclusions tirées par ChatGPT
L’étude a relevé des situations où ChatGPT a transformé des informations contextuelles en conclusions sur les utilisateurs, même sans confirmation expresse de leur part.
Dans un exemple présenté, un utilisateur demandant des recommandations de groupes similaires à Nirvana a vu le chatbot créer une mémoire indiquant son goût pour ce groupe. Bien que plausible, cette conclusion ne découlait pas d’une affirmation directe.
Néanmoins, la majorité des mémoires analysées présentait un lien solide avec les conversations originales. Une évaluation automatisée tenant compte de l’historique disponible a classé 77% d’entre elles comme des informations directement déclarées ou résumées, et 14% comme des inférences jugées logiques.
5% supplémentaires ont été classées comme faiblement étayées et 4% comme non étayées ou contradictoires. Les chercheurs reconnaissent que certaines de ces classifications peuvent provenir de l’absence de fichiers partagés par les utilisateurs, non disponibles pour l’analyse.
La difficulté réside dans le risque que des interprétations erronées soient conservées et réutilisées lors de futures interactions, influençant la personnalisation à partir d’une représentation potentiellement inexacte.
Une proposition pour limiter l’exposition des données
Face à ces constats, l’équipe a développé un mécanisme nommé Attribution Shield, conçu pour reformuler les questions et réduire l’association directe d’informations personnelles aux utilisateurs.
Par exemple, au lieu de formuler « J’ai besoin d’arrêter de consommer du cannabis », le système pourrait suggérer une question plus générale comme « Quelles stratégies existent pour arrêter la consommation de cannabis ? », conservant l’objectif sans attribuer explicitement la situation à la personne.
Lors d’un test expérimental sur environ 36 questions, les chercheurs ont observé que 94,4% des reformulations produites par des modèles ajustés et 100% de celles générées par apprentissage contextuel ont été jugées plus protectrices pour la vie privée par un évaluateur automatique. Une évaluation humaine a confirmé cette tendance, avec des résultats légèrement différents.
Les tests ont aussi indiqué que l’utilité des réponses était généralement préservée. Toutefois, la taille limitée de l’expérience ne permet pas d’affirmer que cette approche empêche la création de mémoires ou élimine les risques d’identification dans des conversations prolongées.
La personnalisation par l’IA nécessite plus de transparence
L’étude met en lumière le défi croissant de trouver un équilibre entre les avantages de la personnalisation et le contrôle des utilisateurs sur les informations stockées.
Il est important de noter que la recherche s’est focalisée sur une implémentation spécifique de la mémoire de ChatGPT. Par conséquent, ses conclusions ne peuvent être étendues automatiquement aux versions actuelles du service ou à d’autres chatbots.
Malgré cela, les auteurs plaident pour des mécanismes permettant aux utilisateurs de mieux comprendre et contrôler la construction de ces profis, surtout lorsqu’ils impliquent des données sensibles ou des interprétations pouvant s’éloigner de la réalité.
La question ne porte pas seulement sur le volume de données conservées par un chatbot, mais aussi sur l’exactitude des conclusions qu’il tire et sur la capacité de chaque individu à maîtriser la représentation numérique que le système élabore à son sujet.