
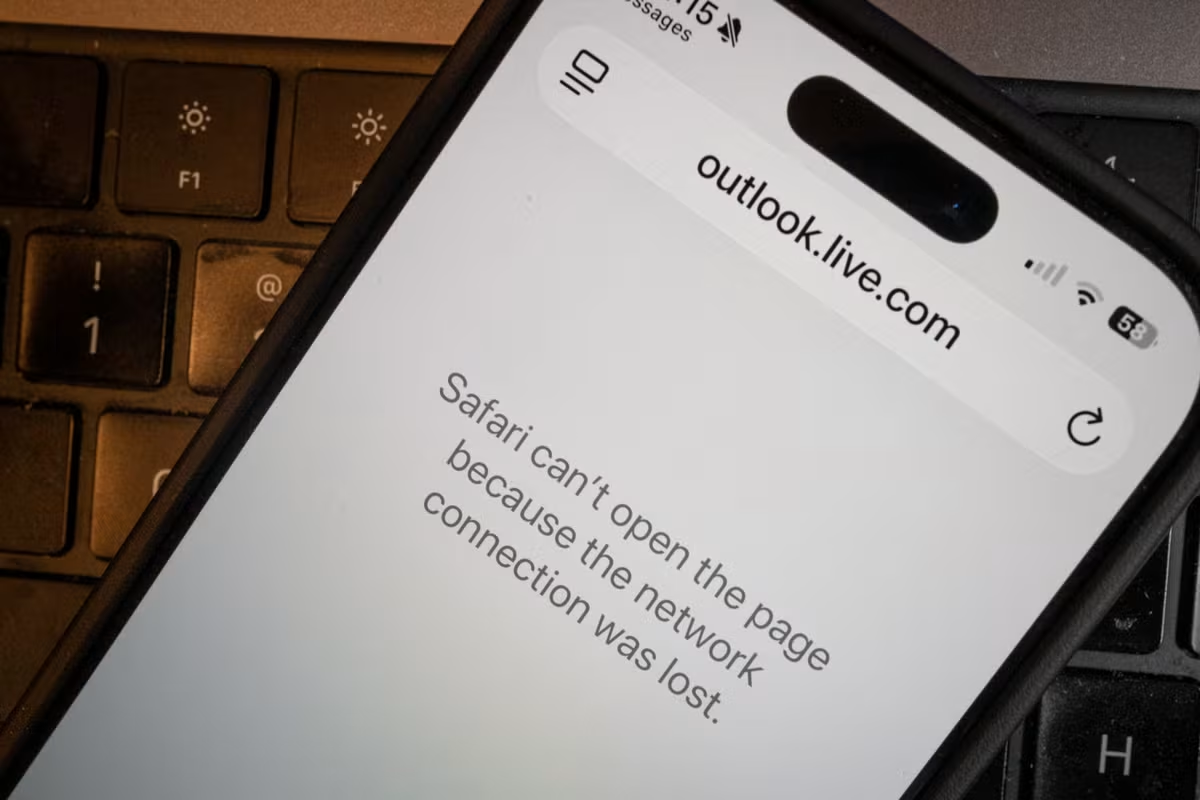
Le groupe informatique a subi une panne planétaire. Le service de messagerie, le stockage en ligne et les outils de réunion sont restés bloqués. Selon un site de suivi des incidents, environ 130 000 personnes signalaient des difficultés d’accès au service de messagerie en début d’après-midi, heure de la côte orientale des États-Unis, soit vendredi matin en Australie. Le groupe a publié un communiqué sur le réseau social. Il a affirmé explorer toutes les pistes pour limiter l’impact et redémarrer les serveurs touchés afin de leur rendre leur service.
Un chercheur rappelait le mois dernier que l’ensemble d’internet ne tombe pas d’un coup, mais que plusieurs services peuvent devenir indisponibles en même temps, car ils reposent sur des systèmes communs. Cette panne illustre exactement ce que produit une défaillance des infrastructures partagées. Elle rappelle la nécessité de préparer les interruptions numériques comme on prépare les catastrophes naturelles.
Au-delà des messages manqués ou des réunions de travail

Le groupe a énuméré une longue liste de prestations potentiellement touchées. Elles regroupent le service de messagerie d’entreprise, la plateforme de visioconférence, la plateforme de partage de documents, l’assistant d’intelligence artificielle, l’outil de planification des tâches et le service de cybersécurité hébergé.
De nombreuses prestations numériques touchées ont produit des effets concrets et étendus. Des équipes de lutte contre la violence familiale n’ont pas pu ouvrir des bases où figuraient les coordonnées des clients. Les écoles n’ont pas pu donner des cours en ligne aux élèves éloignés. Les psychologues n’ont pas pu réaliser des téléconsultations. Les entreprises n’ont pas pu traiter les commandes. Les candidats à l’emploi n’ont pas pu se rendre aux entretiens prévus. Certains centres de services publics ont dû fermer.
Le dérangement a aussi atteint des services extérieurs. Deux entreprises d’intelligence artificielle ont signalé des soucis avec les connecteurs qui reliaient leurs outils à la suite bureautique en ligne. Ce lien montre qu’un incident sur un segment du monde numérique peut frapper des outils qui paraissent distincts, et même des prestations fournies par d’autres entreprises.
L’incident survient après d’autres perturbations plus tôt cette année. En janvier, la messagerie, la visioconférence et d’autres outils de la suite bureautique en ligne ont été indisponibles plusieurs heures. En août, la messagerie et le service d’entreprise ont été perturbés par une mise à jour de code, et la correction a demandé plusieurs jours.
Un récit instable sur l’origine

En début d’après-midi, heure australienne, le groupe informatique n’a pas encore nommé l’origine profonde de la panne. Son récit a évolué depuis la première annonce. La première version évoquait une charge élevée dans plusieurs régions. Le groupe a ensuite précisé que la charge ne résultait pas d’une hausse du trafic. Elle provenait d’un grand nombre de serveurs devenus soudainement indisponibles.
L’attention s’est ensuite portée vers les vérifications automatiques de fonctionnement. Le groupe les utilise pour décider si un serveur peut transporter du trafic. Le module de traitement a aussi retenu l’attention. L’entreprise a décrit un processus central des serveurs touchés comme saturé. Les déploiements de logiciels et les modifications de configuration ont été interrompus. Les changements récents ont été examinés, mais aucun n’a montré un lien avec le début de la panne.
Les indices ne montrent aucune cyberattaque. Une attaque par refus de service distribué consiste à accabler un service sous des requêtes venues de l’extérieur, jusqu’à ce que les demandes légitimes ne reçoivent plus de réponse. Le groupe a dit que le trafic général n’avait pas augmenté, ce qui s’accorde mal avec ce schéma. Aucune preuve d’une activité nocive n’a été publiée, et aucun groupe n’a revendiqué la responsabilité. Le groupe a répété qu’aucun signe ne pointait une cyberattaque.
La version la plus banale correspond mieux aux faits. Les vérifications automatiques de fonctionnement retirent les serveurs qui paraissent fragiles. Quand le mécanisme de décision tombe en panne, une capacité saine disparaît. Les serveurs qui restent doivent absorber une charge pour laquelle on ne les a pas dimensionnés.
À cette échelle, les pannes proviennent plus souvent du fonctionnement interne que d’actions extérieures hostiles. La panne d’août, déclenchée par une mise à jour de code, le montre. Qu’un bilan complet n’est pas publié, cette lecture reste une hypothèse tirée des communiqués du groupe, et non un constat clos.
Le groupe n’a pas encore réglé l’incident de façon totale. Certains serveurs touchés sont de nouveau en service, mais ils peuvent redevenir sourds dès qu’ils reçoivent du trafic.
Planifier les pannes comme les feux de brousse

Cette panne confirme l’obligation de mieux préparer les interruptions numériques. Pour les personnes, la préparation demande de conserver hors ligne les informations essentielles, comme les contacts ou les ordonnances médicales. Les organismes qui dépendent d’un seul fournisseur numérique doivent bâtir des plans de secours. Ils doivent surtout éprouver ces plans, car un simple document sur papier ne suffit pas, comme avec les exercices d’incendie ou les évacuations face aux feux de brousse.
La multiplication des éléments connectés, entre véhicules, habitations, lieux de travail, transports et santé, élargit les conséquences possibles. L’usage plus large de l’intelligence artificielle accroît aussi les effets. La résilience doit faire partie des projets d’avenir.