
La cybersécurité dépasse les simples antivirus et mots de passe. Elle repose sur une anticipation stratégique des attaques via la modélisation des menaces, une méthode proactive pour identifier les vulnérabilités et renforcer les défenses avant toute exploitation malveillante.
La cybersécurité ne se limite pas à installer un antivirus, configurer un pare-feu ou utiliser des mots de passe complexes. Un pilier essentiel de la protection d’un système consiste à anticiper les attaques possibles et à comprendre comment un cybercriminel pourrait exploiter ses faiblesses. C’est exactement là qu’intervient la modélisation des menaces (Threat Modeling).
Qu’est-ce que la modélisation des menaces ?
La modélisation des menaces est un processus structuré qui permet d’identifier, d’analyser et d’évaluer les menaces potentielles pour un système, une application, un réseau ou un service numérique.
Son but est de comprendre ce qui pourrait mal tourner, comment une attaque pourrait survenir et quelles mesures mettre en œuvre pour réduire le risque.
Plutôt que d’attendre qu’une vulnérabilité soit découverte par un attaquant, l’organisation cherche à anticiper les scénarios d’attaque et à définir des mécanismes de protection adaptés.
Par exemple, lors du développement d’une application bancaire, l’équipe peut analyser comment un attaquant pourrait voler des identifiants, contourner l’authentification, accéder aux données d’autres clients ou manipuler un virement.
En identifiant ces scénarios tôt, il devient possible de corriger les failles d’architecture et d’intégrer des contrôles de sécurité avant le déploiement de l’application.
Comment fonctionne la modélisation des menaces ?
Bien que diverses méthodologies existent, le processus suit généralement une série d’étapes.
1. Identifier le système et ses actifs
La première étape est de comprendre le système à protéger et d’identifier les actifs les plus importants : données personnelles, identifiants, bases de données, services critiques et interfaces de communication.
Il faut aussi saisir comment ces éléments interagissent et quels composants nécessitent une protection.
2. Identifier les menaces potentielles
Cette phase consiste à déterminer qui pourrait attaquer le système, quels sont ses objectifs et quelles méthodes il pourrait employer.
Les menaces incluent le vol d’identifiants, l’exploitation de vulnérabilités, les attaques par déni de service, l’élévation de privilèges, la fuite d’information ou la compromission de fournisseurs.
3. Analyser la surface d’attaque
La surface d’attaque correspond à l’ensemble des points par lesquels un attaquant peut tenter de compromettre le système.
Elle peut inclure les ports réseau exposés, les API, les applications Web, les services distants, les équipements IoT, les comptes utilisateurs et les intégrations avec des plateformes externes.
Mieux cette surface est connue, plus il est facile de repérer les points d’entrée à sécuriser.
4. Évaluer les risques
Toutes les menaces n’ont pas le même niveau de risque. Il faut évaluer la probabilité qu’un scénario se produise et l’impact qu’il aurait sur l’organisation.
Une vulnérabilité permettant d’accéder à une base de données sensible représente un risque bien plus élevé qu’une faille aux conséquences limitées.
5. Définir les mesures d’atténuation
Après l’identification et l’évaluation des risques, des mesures doivent être définies pour les réduire.
Celles-ci peuvent inclure l’authentification multifacteur (MFA), le chiffrement, la segmentation réseau, la validation des données, la limitation des privilèges, la surveillance des événements et des mécanismes de détection et réponse aux incidents.
La modélisation des menaces n’élimine pas tous les risques, mais elle permet de les traiter de manière structurée et raisonnée.
STRIDE, une des méthodologies les plus connues
Une approche courante en modélisation des menaces est STRIDE, un modèle développé par Microsoft qui organise les menaces en six catégories.
- Spoofing (usurpation d’identité) : lorsqu’un attaquant se fait passer pour un utilisateur, un service ou un système légitime.
- Tampering (altération) : modification non autorisée de données, de configurations ou de code.
- Repudiation (répudiation) : impossibilité de prouver de manière fiable une action, par exemple en l’absence de journaux d’activité.
- Information Disclosure (divulgation d’information) : accès ou exposition non autorisée de données.
- Denial of Service (déni de service) : actions rendant un système ou un service indisponible.
- Elevation of Privilege (élévation de privilèges) : obtention d’autorisations supérieures à celles normalement attribuées à un utilisateur ou processus.
STRIDE aide les équipes de développement et de sécurité à analyser systématiquement différents types de menaces, évitant une focalisation exclusive sur les vulnérabilités les plus évidentes.
D’autres approches existent, comme PASTA, qui privilégie une analyse des risques alignée sur les objectifs métier, et OCTAVE, centré sur l’évaluation des risques liés à la sécurité de l’information.
La modélisation des menaces peut être complétée par d’autres modèles et cadres de référence en cybersécurité, notamment le MITRE ATT&CK et la Cyber Kill Chain.
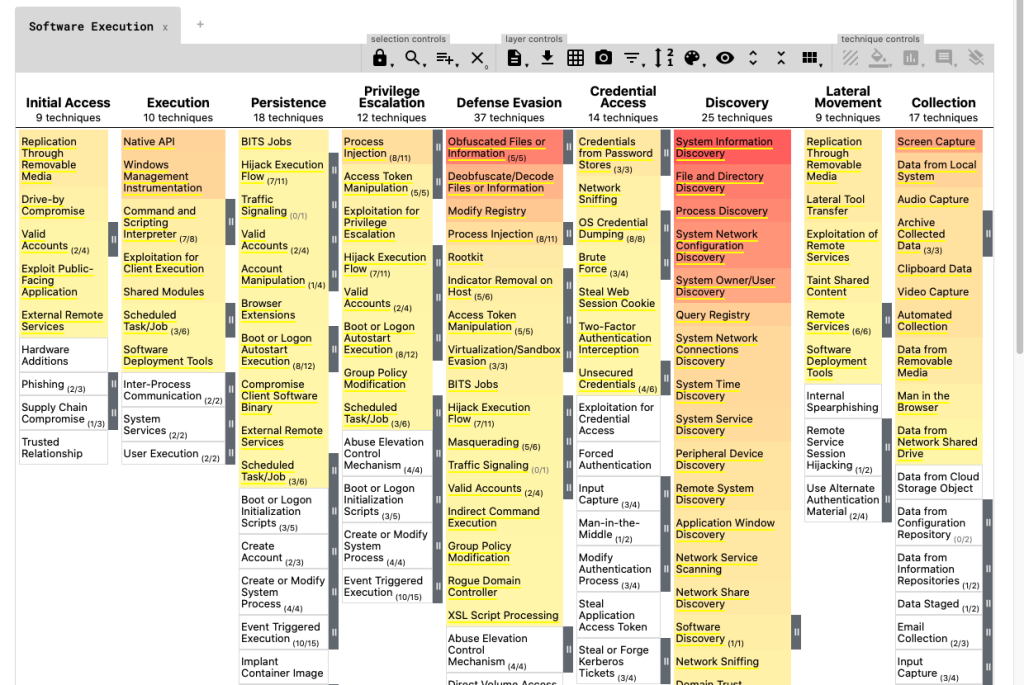
Le MITRE ATT&CK documente les tactiques, techniques et procédures utilisées par des attaquants réels. Il aide à comprendre comment une menace peut évoluer après l’accès à un système et quels comportements doivent être détectés.
De son côté, la Cyber Kill Chain décrit les différentes phases d’une opération offensive, depuis la reconnaissance initiale jusqu’aux actions sur les objectifs. Ce modèle permet d’analyser à quels moments une attaque peut être interrompue.
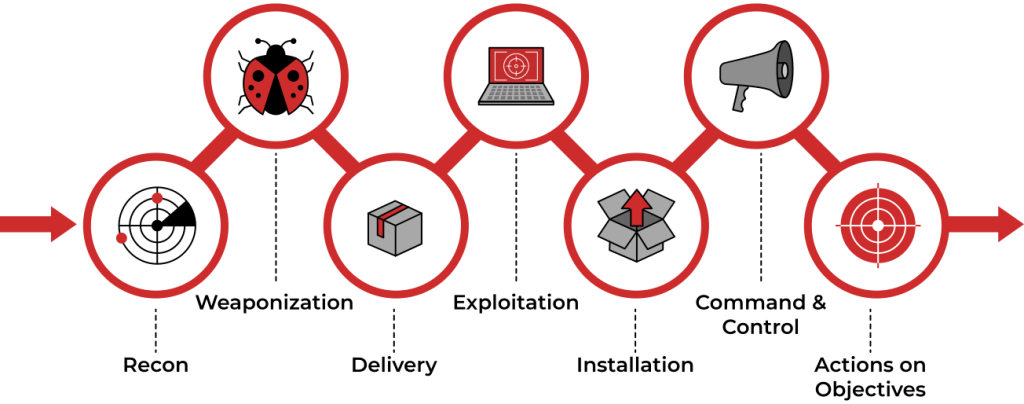
Alors que la modélisation des menaces anticipe les risques et identifie des protections, le MITRE ATT&CK aide à comprendre le comportement des attaquants et la Cyber Kill Chain permet d’analyser la séquence d’une attaque.
L’utilisation conjointe de ces approches peut renforcer la cohérence d’une stratégie de défense.